
متى يتفوق نموذج مفتوح خضع للـ fine-tuning على GPT أو Claude في مهام الإنتاج المتخصصة.
النماذج الرائدة للاستكشاف، والنماذج المتخصصة للتوسع. استراتيجية عملية لاختيار النماذج في أنظمة الذكاء الاصطناعي الإنتاجية.
السؤال ليس عن أكبر نموذج.
السؤال الصحيح هو: أي نموذج يمنح أفضل نتيجة لهذه المهمة بالتحديد، وبالتكلفة وزمن الاستجابة ومستوى التحكم المناسب؟ هذا الإطار في التفكير هو ما يفصل بين نموذج أولي أنيق ونظام يعمل فعليًا على نطاق واسع.
النموذج الرائد
الخيار الأفضل للنماذج الأولية الأولى، والتفكير الواسع، والحالات الحدية غير المعروفة، والمهام التي لا تتوفر لها بيانات موسومة كافية للتدريب.
النموذج المفتوح المخصص بالـ fine-tuning
الخيار الأفضل عندما تكون المهمة مستقرة ومتكررة ومرتبطة بمجال محدد وقابلة للقياس عبر مجموعة تقييم واضحة.
غالبًا ما يكون GPT وClaude أفضل نقطة انطلاق، لكنهما ليسا دائمًا الخيار الأفضل للتشغيل على نطاق واسع.
تشبيه بسيط.
النموذج الرائد هو خبير شامل لامع. يستطيع التفكير في نطاق واسع، والتعامل مع الغموض، ومساعدتك على الوصول إلى الحل الصحيح بسرعة.
أما النموذج المفتوح المخصص بالـ fine-tuning فهو متخصص مدرب. يتعلم مصطلحاتك وصيغك وحالاتك الحدية ومعيار الجودة لديك بالضبط. وفي العمل المتكرر، يمكن لهذا التخصص أن يتفوق على الخبير الشامل.
استخدم الخبير الشامل للتعلم، واستخدم المتخصص للتوسع.
ماذا تقول الأدلة المنشورة.
ثلاث دراسات مستقلة من عامي 2024 و2025 تروي القصة نفسها من زوايا مختلفة. لا تدعي أي منها أن النماذج الصغيرة أفضل في كل الحالات، لكنها تظهر جميعًا أنه في المهمة المناسبة يمكن لنموذج مفتوح مخصص بالـ fine-tuning أن يتفوق في المقياس الذي يهم فعلًا.
الـ fine-tuning يحقق تحسنًا خاصًا بالمهمة.
عبر 31 مهمة جرى قياسها في تقرير LoRA Land الصادر عن Predibase، تحسنت معظم النماذج الأساسية تحسنًا كبيرًا بعد fine-tuning خاص بالمهمة. الرسالة هنا هي التخصيص، وليس حجم النموذج وحده. يمكن لنموذج أصغر أن يصبح عاملًا إنتاجيًا أقوى عندما يدرب على المهمة التي تهمك بالضبط.
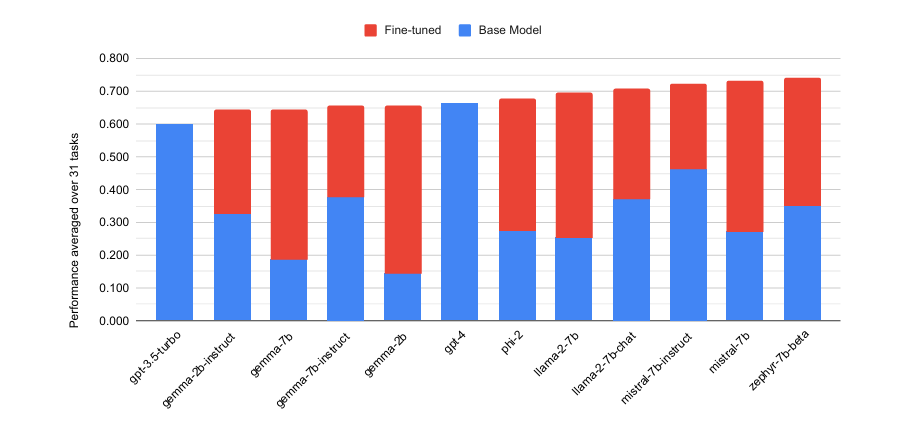 النموذج الأساسي (بالأزرق) مقابل النموذج نفسه بعد الـ fine-tuning بتقنية LoRA (بالأحمر)، بمتوسط 31 مهمة. المصدر: Predibase LoRA Land، 2024.
المصدر: Predibase LoRA Land، arXiv:2405.00732 (2024).
أخطاء البنية هي إخفاقات في الإنتاج.
في المخرجات المهيكلة مثل JSON الخاص بسير العمل، يجب أن يكون المخرج صالحًا، لا مجرد نص سلس. في اختبار معياري لتوليد سير العمل من ServiceNow:
- Mistral-Nemo-12B بعد الـ fine-tuning: أخطاء بنسبة 5.6% على مجموعة الاختبار، و1.0% خارج التوزيع.
- GPT-4o: 17.3% على الاختبار، و11.0% خارج التوزيع. في أتمتة المؤسسات، النموذج الفائز هو الذي يلتزم بالـ schema وقواعد العمل لديك بأكبر قدر من الموثوقية.
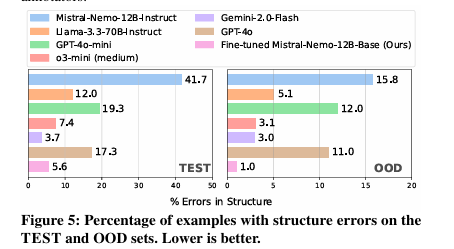 نسبة أخطاء البنية على مجموعتي التقييم TEST وOOD. الأقل هو الأفضل. المصدر: ServiceNow / KDD Workshop 2025، الشكل 5.
المصدر: ServiceNow / KDD Workshop 2025، arXiv:2505.24189.
الـ fine-tuning يمكن أن يقلب الترتيب.
في دراسة حالة للتدوين الطبي في قطاع الرعاية الصحية، بدأ النموذج المفتوح خلف النموذج الرائد المرجعي، ثم أصبح صاحب الأداء الأعلى بعد التدريب الخاص بالمهمة:
- Gemma 3 27B الأساسي: نسبة نجاح 34.6%.
- Claude Sonnet 4: نسبة نجاح 53.2%.
- Gemma 3 27B بعد الـ fine-tuning: نسبة نجاح 85.1%. لم يصبح النموذج أذكى في كل شيء، بل أصبح أفضل بكثير في هذه المهمة الواحدة.
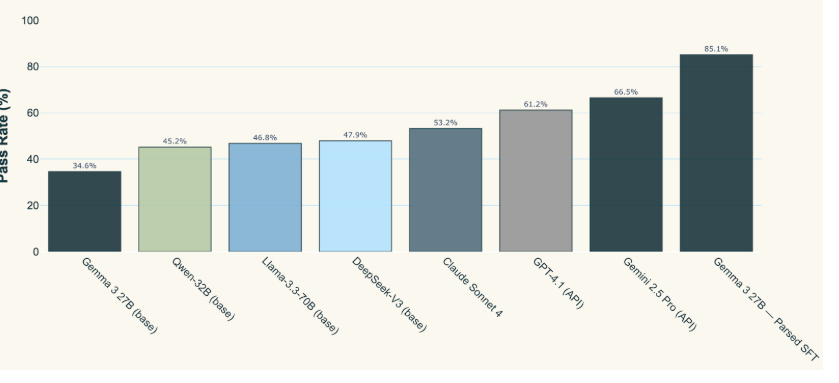 نسبة النجاح لكل نموذج في اختبار التدوين الطبي. يبدأ Gemma 3 27B خلف واجهات API الرائدة وينتهي في صدارة الأداء بعد الـ fine-tuning. المصدر: Together AI / Parsed، 2025.
المصدر: دراسة حالة التدوين الطبي في الرعاية الصحية من Together AI / Parsed (2025).
الأداء النسبي في مهمة التدوين الطبي، مع اعتبار Claude Sonnet 4 = 100.
أين يرجح أن يتفوق الـ fine-tuning.
النمط ثابت عبر الدراسات الثلاث: مهمة مستقرة، وأمثلة واضحة، وجودة قابلة للقياس، وتكرار مرتفع. يتفوق المتخصص عندما يكون توزيع المخرجات ضيقًا. وهذا شائع في بيئات الإنتاج. لا تحتاج المؤسسة إلى نموذج يجيب عن كل سؤال في العالم، بل تحتاج إلى نموذج يؤدي سير عمل واحدًا بإتقان شديد.
JSON وXML والجداول والنماذج والقوالب والصياغة المضبوطة.
المجالات الطبية والقانونية والمالية، وأسماء المنتجات الداخلية، وقواعد العمليات المؤسسية.
تصنيف طلبات الدعم، واستخراج البيانات من المستندات، وتحليل الفواتير، والتوجيه.
نبرة خاصة بكل عميل، وصيغة الملاحظات، وبنية التقارير، وصياغة الامتثال.
الـ fine-tuning يدمج التصحيحات المتكررة داخل النموذج بدلًا من تضخيم الـ prompt إلى ما لا نهاية.
شغل النموذج داخل بيئتك وتحكم في مسار البيانات الحساسة.
لماذا الـ fine-tuning أصلًا؟ الدقة ليست السبب الوحيد.
نجاح الإنتاج لا يقتصر على درجة النموذج، بل يشمل التحكم والأمان والتكلفة وزمن الاستجابة والموثوقية. تخصيص نموذج مفتوح أصغر على مهمتك عبر الـ fine-tuning يمنحك مجموعة مقايضات مختلفة عن واجهة API لنموذج رائد:
- شغل النموذج في بيئتك الخاصة أو السحابة التي تفضلها.
- أبق البيانات الحساسة تحت حوكمة أشد وضوابط تدقيق أدق.
- خفض تكلفة كل استدعاء في مهام سير العمل عالية الحجم.
- قلل زمن الاستجابة بنموذج أصغر محسن للمهمة.
- حدث النموذج عندما تتغير عمليات العمل.
- قلل الارتباط بمزود واحد واحتفظ بالتحكم في الإصدارات.
يحصل العميل على نموذج مصمم حول سير عمله، لا على نموذج عام يطلب منه التصرف كأنه كذلك.
دليل اتخاذ القرار.
لا يوجد نهج صحيح في كل الحالات. يعتمد الاختيار على ما إذا كانت المشكلة لا تزال متغيرة أم استقرت لتصبح مهمة إنتاجية قابلة للتكرار.
- المتطلبات لا تزال تتغير.
- تفكير واسع أو بحث أو أسئلة متعددة المجالات.
- حجم استخدام منخفض لا يعوض جهد التدريب.
- بيانات موسومة محدودة أو غياب تقييم موثوق حتى الآن.
- سير العمل مستقر بما يكفي لتحديد أمثلة.
- يمكنك بناء مجموعة اختبار ذهبية وفحوصات نجاح ورسوب واضحة.
- الـ schema والصيغة والأسلوب والمصطلحات أمور مهمة.
- لديك ما يكفي من الأمثلة التمثيلية للتدريب عليها.
- حجم استخدام مرتفع، فتتراكم الوفورات مع الوقت.
- الخصوصية وقابلية التدقيق والاستقلال عن المزود أمور مهمة.
عندما تتحقق هذه الشروط، غالبًا ما يكون النموذج الأصغر المخصص بالـ fine-tuning هو النموذج الإنتاجي الأفضل.
هل سير عملك مناسب لهذا النمط؟
نحن نقدم استكشافًا مدفوعًا، لا تجارب مجانية. إذا كان فريقك يشغل سير عمل مستقرًا وعالي الحجم على واجهة API لنموذج رائد، وبدأت التكلفة أو محدودية التحكم تسبب لكم الضرر، فهذا بالضبط الموضع الذي يؤتي فيه هذا الحوار ثماره.
المراجع
- ServiceNow / KDD Workshop 2025. Fine-Tune an SLM or Prompt an LLM? The Case of Generating Low-Code Workflows. arXiv:2505.24189
- Predibase, 2024. LoRA Land: 310 Fine-tuned LLMs that Rival GPT-4, A Technical Report. arXiv:2405.00732
- Together AI / Parsed, 2025. Fine-Tuning Small Open-Source LLMs to Outperform Large Closed-Source Models by 60% on Specialized Tasks. تنبيه: تعتمد النتائج على جودة البيانات وتصميم التقييم واستقرار المهمة وقوة النماذج المرجعية. ينبغي إثبات جدوى الـ fine-tuning عبر تجربة أولية، لا افتراضها مسبقًا.